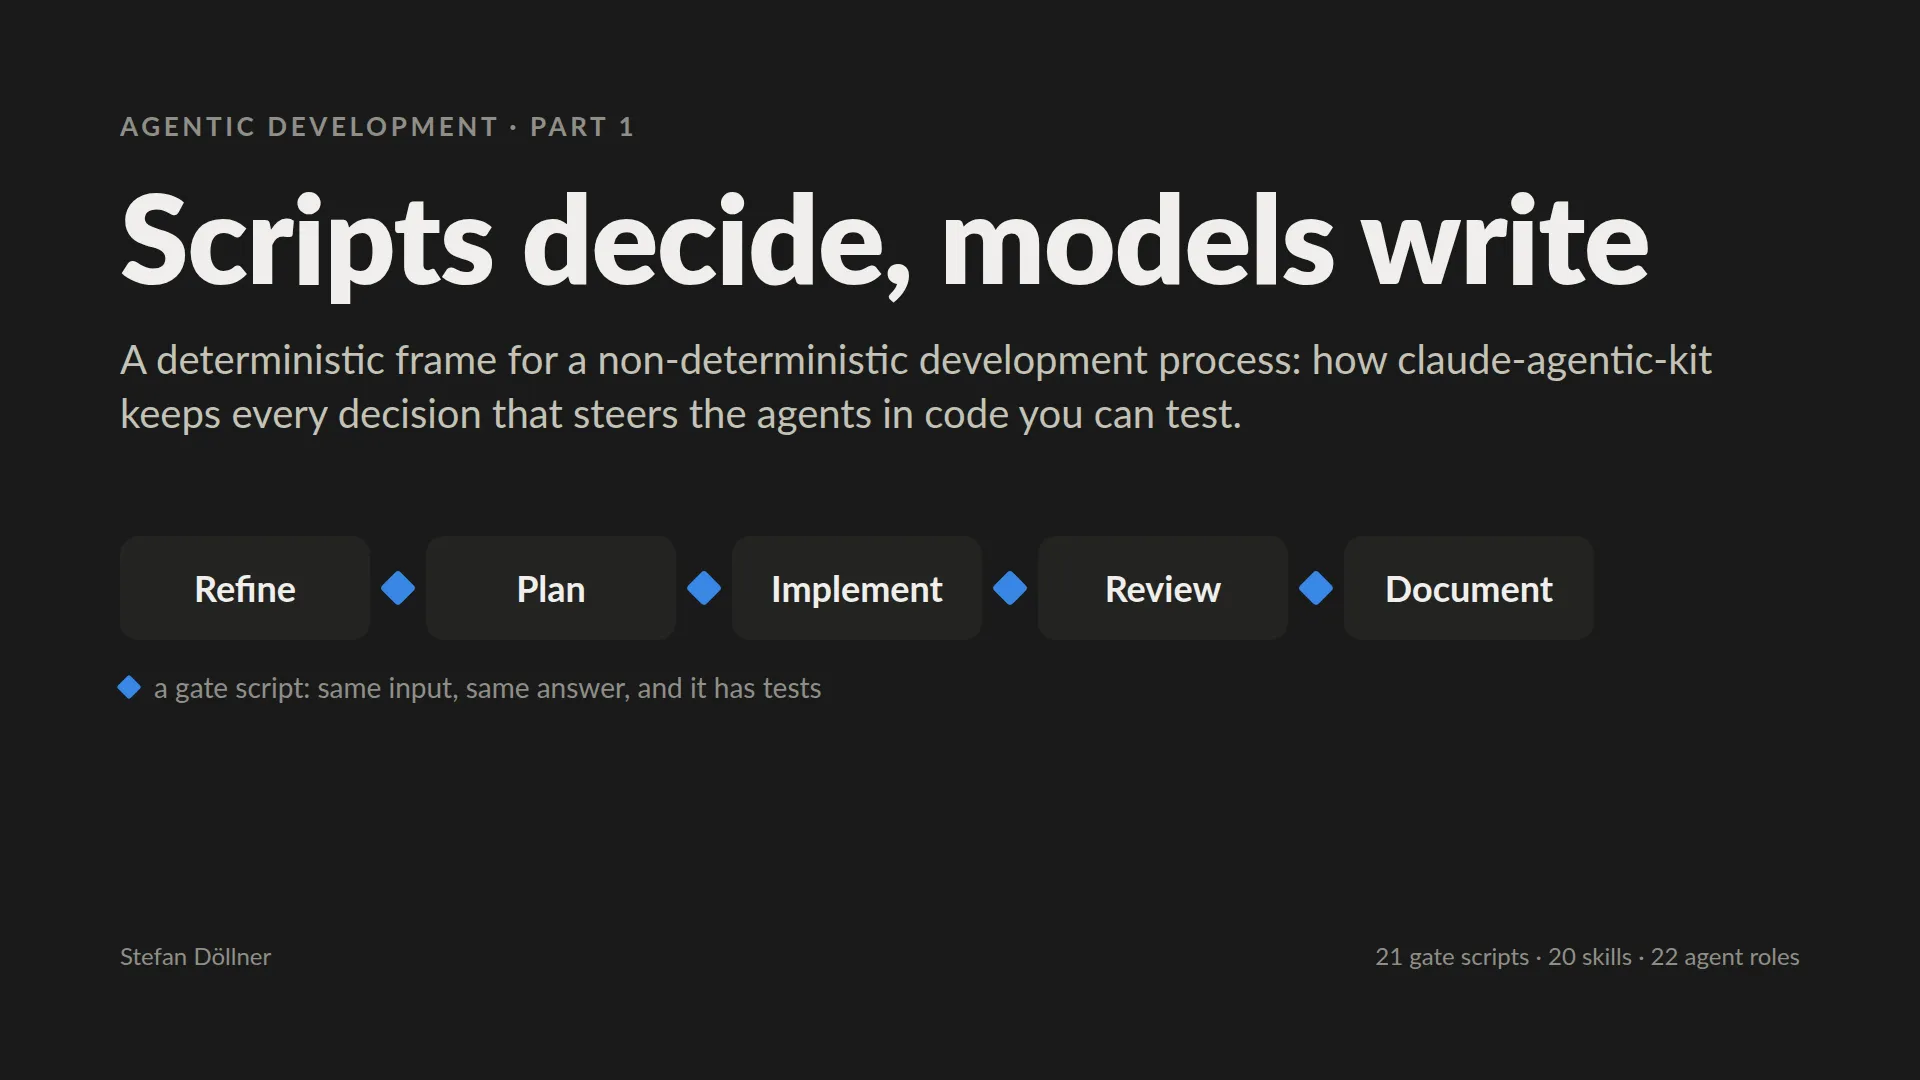
Skripte entscheiden, Modelle schreiben
Etwa drei von vier Commits im main-Branch von Trusq haben einen Coding-Agenten als Co-Autor. Und Entwicklung mit Agenten ist nichtdeterministisch. Derselbe Prompt ergibt beim nächsten Run einen anderen Plan. Ein neuer Reviewer findet andere Fehler als der vorige. Und die Modelle dahinter, Claude Opus, Sonnet und Haiku, ändern sich mit jedem Release. Diese Unterschiede zwischen den Runs will ich gar nicht abstellen. Gerade sie sorgen für einen großen Teil der Qualität. Der Prozess drumherum soll aber vorhersehbar bleiben.
Deshalb habe ich ein Kit für Claude Code gebaut, das dieser Arbeit einen deterministischen Rahmen gibt. Die Modelle schreiben Spezifikationen, Pläne, Code, Tests und Reviews. Skripte entscheiden, welcher Schritt als Nächstes kommt, wann ein Review fertig ist, wann eine Änderung blockiert wird und wann ein Mensch draufschauen muss. Bei gleichem Input geben diese Skripte immer dieselbe Antwort, und sie haben Tests. Kurz gesagt: Modelle schreiben, Skripte entscheiden.
Das Kit heißt claude-agentic-kit. Es ist ab März 2026 im Trusq-Repository entstanden, wurde im April ein eigenes Projekt und steht inzwischen bei Version 1.16. Ich habe es entworfen und die Entwicklung gesteuert. Gebaut haben es größtenteils Agenten, und zwar mit seiner eigenen Pipeline und innerhalb seines eigenen Rahmens. Von den 50 Einträgen im Backlog sind 40 erledigt.
Der Rahmen
Jede Aufgabe durchläuft dieselben fünf Schritte in derselben Reihenfolge: Refinement, Planung, Umsetzung, Review und Dokumentation. Was in einem Schritt passiert, ist bei jedem Run anders. Der Rahmen bleibt aber gleich. Im Refinement wird aus einem groben Backlog-Eintrag eine Spezifikation, und der Agent fragt mich nur, was er nicht im Code nachschlagen kann. Die Planung teilt die Arbeit in Pull Requests mit etwa 20 Dateien, höchstens 50. Umgesetzt wird testgetrieben in einem eigenen Git-Worktree, also fasst ein Agent nie meine Working Copy an. Im Review haben Agenten nur eine Aufgabe: Fehler finden. Und fertig ist etwas erst, wenn die Dokumentation stimmt.
Jeder Schritt ist ein Skill, dem der Agent folgt. Zwischen den Schritten stehen kleine Programme, die der Agent aufrufen muss und mit denen er nicht diskutieren kann. Es gibt 21 solcher Gate-Skripte, dazu 20 Skills und 22 Agent-Rollen. In den Skills und Rollen arbeiten die Modelle. Die Gate-Skripte bilden den Rahmen.
Ein Review-Loop mit vier möglichen Antworten
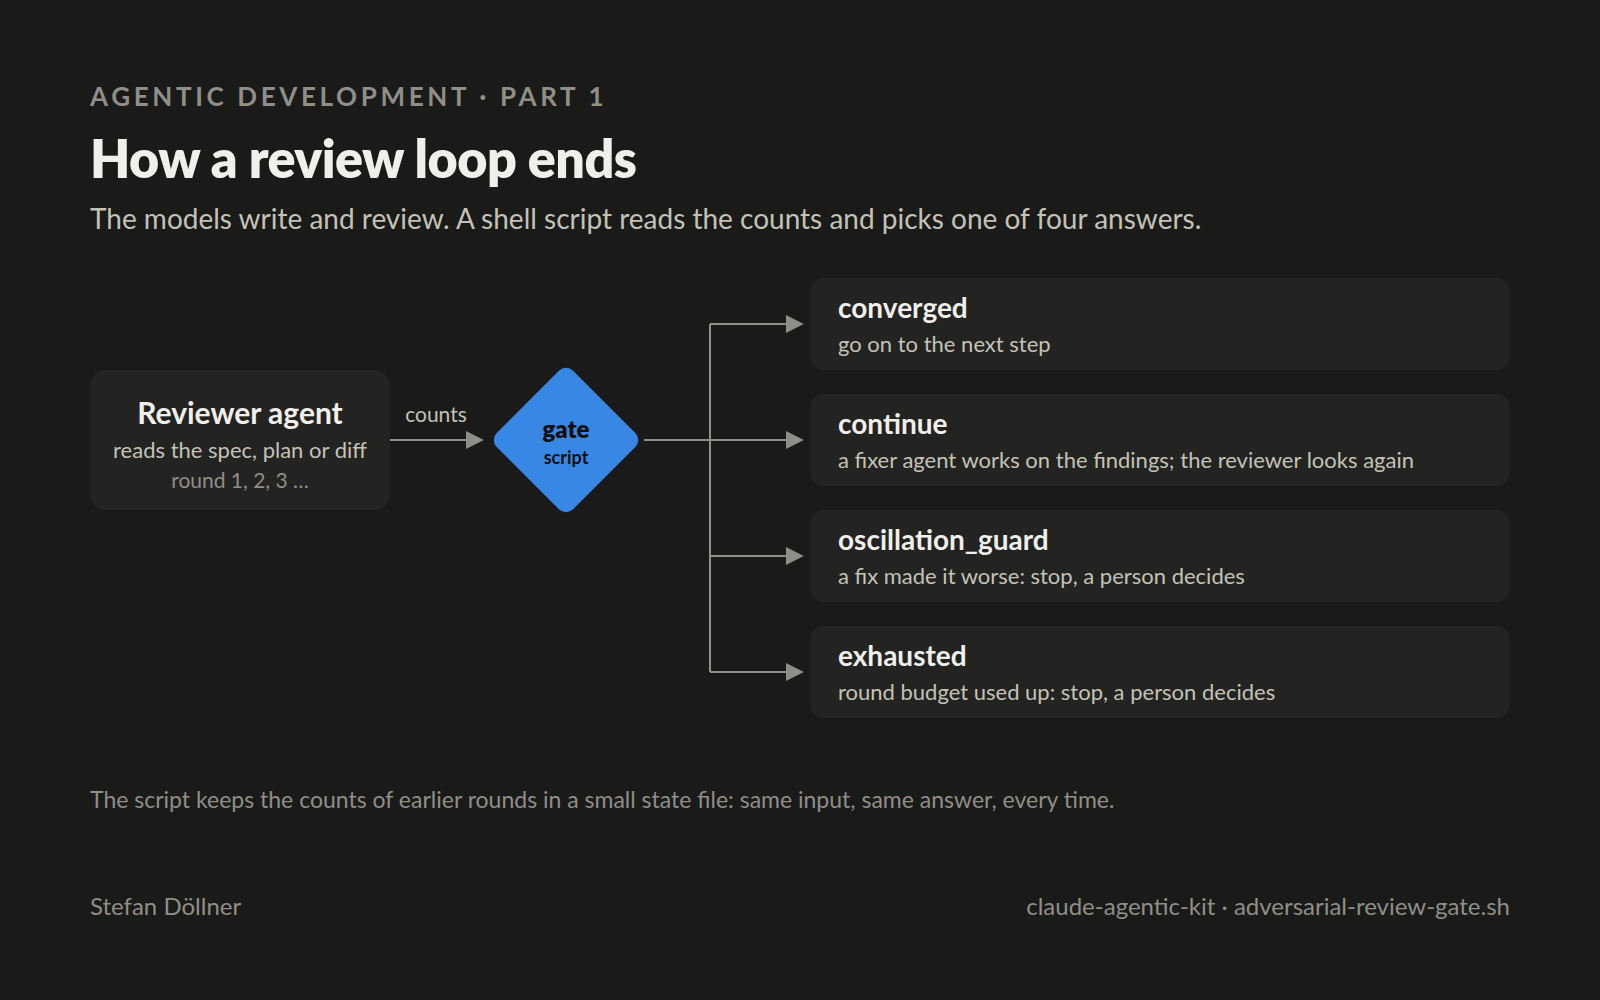
Am deutlichsten wird das beim Gate, das ein Review beendet. Ein Reviewer liest eine Spezifikation, einen Plan oder einen Diff und meldet, wie viele kritische Findings und Warnings er gefunden hat. In den ungeraden Runden prüft Opus, in den geraden Sonnet, denn verschiedene Modelle finden verschiedene Fehler. Ein Fix-Agent auf Haiku arbeitet die Findings ab, dann schaut der nächste Reviewer drauf. Und irgendwann stellt sich die Frage: Wann ist Schluss?
Die Findings sind der nichtdeterministische Teil, und das ist auch gut so. Ein frischer Blick findet eben, was der vorige übersehen hat. Genau deshalb kann ein Modell aber schlecht beurteilen, wann der Loop fertig ist. Entweder hält es die Arbeit für fertig, weil die Liste kürzer geworden ist. Oder es macht endlos weiter, weil sich immer noch etwas finden lässt. Deshalb entscheidet bei uns ein Shell-Skript. Es nimmt die Zahlen der aktuellen Runde, liest die früheren Runden aus einer kleinen State-Datei und gibt genau eines von vier Wörtern aus: converged, continue, oscillation_guard oder exhausted. Oscillation heißt, dass ein Fix die Sache schlimmer gemacht hat. Exhausted heißt, dass die Änderung alle Runden verbraucht hat, die ihr nach ihrer Größe zustehen. In beiden Fällen hält der Loop an, und ein Mensch schaut drauf.
Der Grund steht im Kommentar oben im Skript: „Pulling state-machine logic out of the main model's context makes the gate testable and insulates it from main-model downgrades." Wie viele Runden der Loop dreht, ist jedes Mal anders. Wie er endet, steht aber im Code. Und das gilt auch dann, wenn das aufrufende Modell gerade keinen guten Tag hat.
Aus Fehlern werden Prüfungen
Das zweite Gate macht aus den Fehlern der Agenten Prüfungen. Nach dem Merge durchsucht ein Skill die Review-Kommentare und Review-Runden nach Fehlern, die immer wieder vorkommen, und trägt sie in einen Katalog ein. Bevor ein Schritt startet, wählt ein Skript die zehn wichtigsten Einträge für diesen Schritt aus, nach Häufigkeit und Schwere, und schreibt sie in den Prompt des Agenten. Die Fehler findet also ein Modell. Welche davon der nächste Agent zu sehen bekommt, entscheidet aber ein Skript, und diese Auswahl kann jeder nachprüfen.
Manche Einträge haben eine feste Signatur, also eine Codezeile, von der wir wissen, dass sie falsch ist. Dann sucht das Skript zusätzlich in der Änderung danach und stoppt den Run, sobald sie auftaucht. Dabei prüft es nur die hinzugefügten Zeilen. Ein Pull Request, der das falsche Muster entfernt, wird also nicht blockiert, nur weil es im Diff vorkommt. Einträge, für die man ein Urteil braucht, bleiben Hinweise. Blockieren darf nur, was eine Maschine zuverlässig prüfen kann. So bleibt auch der Rahmen selbst deterministisch.
Modellwahl nach Regel statt nach Gewohnheit
Auch welches Claude-Modell welche Aufgabe übernimmt, gehört zum Rahmen. Jede wiederkehrende Rolle hat eine eigene Agent-Datei, in der Opus, Sonnet oder Haiku fest eingetragen ist. Die Wahl hängt also nicht davon ab, was der Haupt-Agent in einem Run gerade aussucht. Die Regel dahinter: Nimm das günstigste Modell, das drei Fragen besteht. Welche Art Aufgabe ist es? Was geht raus, wenn der Agent schlecht arbeitet? Und prüft danach noch ein Gate oder ein frischer Reviewer das Ergebnis?
Offene Abwägungen, bei denen ein Fehler unbemerkt bliebe, bekommt Opus: eine Spezifikation entwerfen, ein Security-Review planen und das gründliche Correctness-Review eines Pull Requests. Checklisten-Reviews, Recherche und Planung macht Sonnet. Haiku übernimmt Fixes nach einer klaren Liste von Findings, den Abgleich der Umsetzung mit dem Plan und das reine Lesen im Code. Bei der dritten Frage zahlt sich der Rahmen aus. Weil ein Gate oder ein Reviewer das Ergebnis prüft, kann ein günstigeres Modell gefahrlos den Entwurf schreiben. Über Opus legt das Kit nie etwas fest. Ob die Hauptsession auf einem größeren Modell läuft, entscheidet der Operator.
Wo die Grenze verläuft
Ob Code gut ist, beurteilt nie ein Skript. Das machen weiterhin die Modelle, und sie machen es gut, wenn sie sich mit einem klaren Auftrag gegenseitig prüfen. Die Grenze verläuft zwischen Inhalt und Ablauf. Der Inhalt ist nichtdeterministisch, und das darf er auch bleiben. Der Ablauf dagegen ist deterministisch: weitermachen, anhalten, blockieren oder einen Menschen fragen. Was die Modelle liefern, fließt also in diese Entscheidung ein. Die Entscheidung selbst treffen sie nicht.
Was sich übertragen lässt
Das ist nichts KI-Spezifisches. Verteilte Systeme funktionieren schon immer so. Ein Netzwerk kann man nicht zuverlässig machen, also baut man Timeouts, Retries und Circuit Breaker drumherum. Und die sind ganz normaler Code mit Tests. Agenten sind eine weitere nichtdeterministische Komponente, wenn auch eine ungewöhnlich fähige. Deshalb gilt dasselbe Engineering: Die Komponente darf variieren, der Rahmen drumherum ist deterministisch, und alles, was sie liefert, ist Input.
Nächsten Mittwoch: wie sich das Kit gegen Spec Kit, Superpowers, Matt Pococks Skills und die anderen schlägt und welche Entscheidungen jedes davon einem Modell überlässt.